2026年10月2日
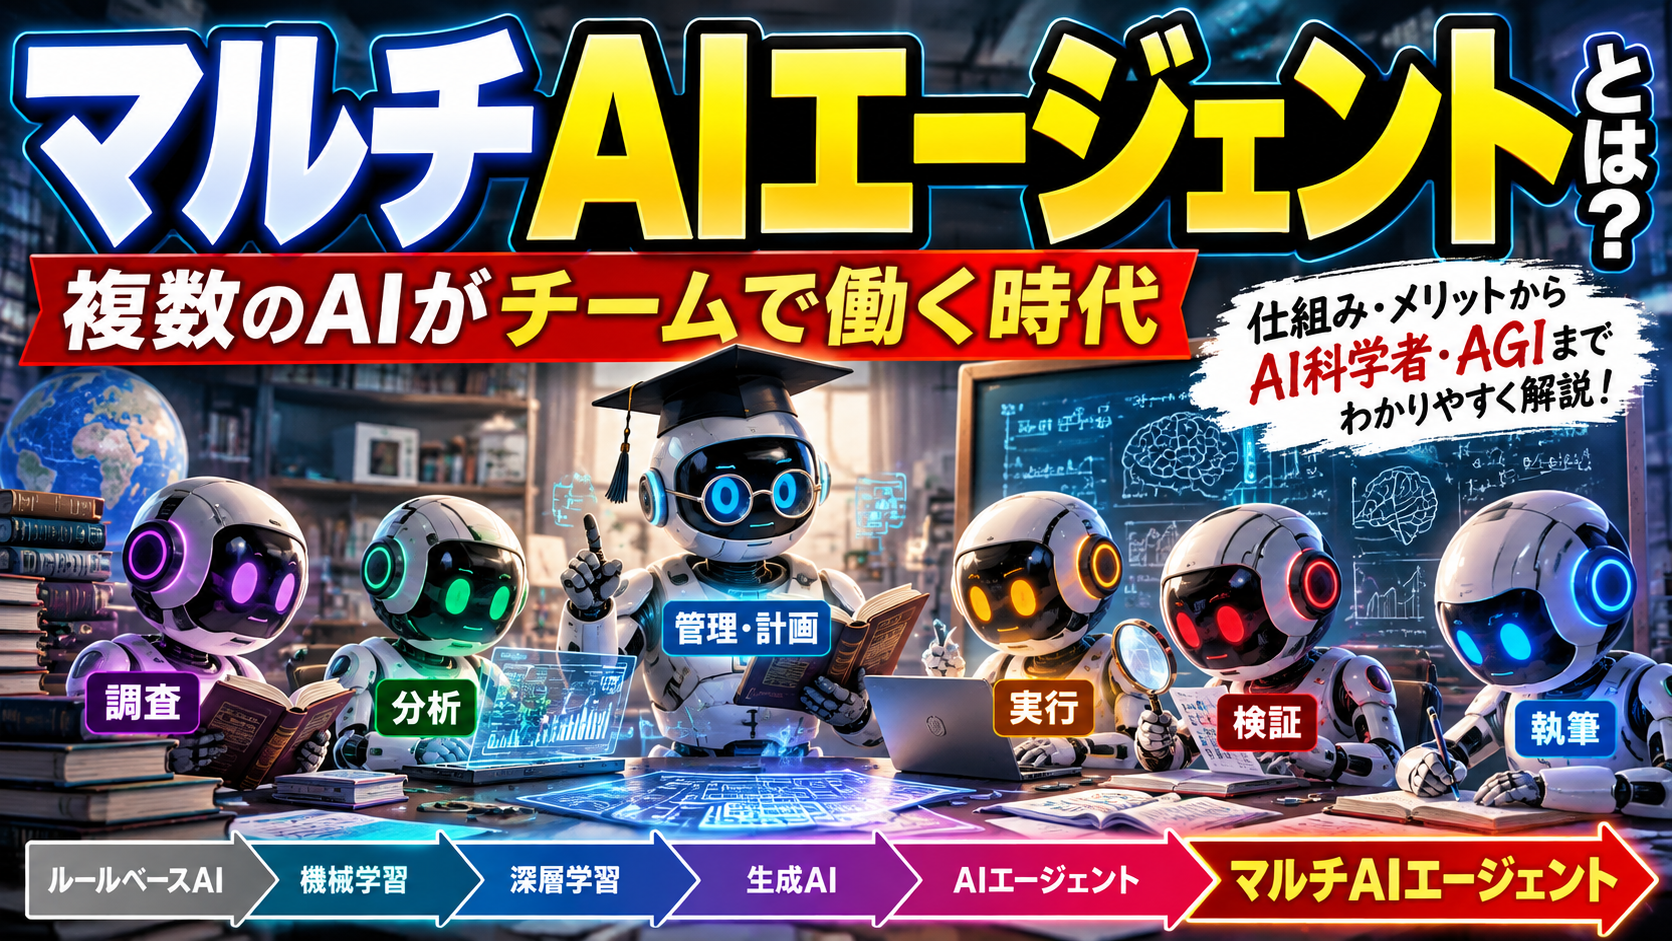
生成AIの次の進化として注目されているのが、「マルチAIエージェント」です。
複数のAIがそれぞれ異なる役割を持ち、計画・調査・分析・実行・検証を分担することで、AIは「質問に答える存在」から「チームとして仕事を進める存在」へ変わりつつあります。
本記事では、マルチAIエージェントの仕組みを大学の研究室に例えながら、初心者にもわかりやすく解説します。
具体的には、以下のテーマを取り上げます。
- AIエージェントとマルチAIエージェントの違い
- マルチAIエージェントの仕組み
- 複数のAIを利用するメリット・デメリット
- AI科学者とは何か
- 再帰的自己改善(RSI)とは何か
- AGI(汎用人工知能)との関係
- 2026年時点でどこまで実現しているのか
- 今後3年間でAIはどのように進化する可能性があるのか
AIが「一人の優秀な助手」から、複数のAIが協力するチームや組織へ進化すると何が変わるのか。
マルチAIエージェントの基本から、その先にあるAI科学者やAGIの可能性まで順番に見ていきましょう。
AIはどのように進化してきたのか
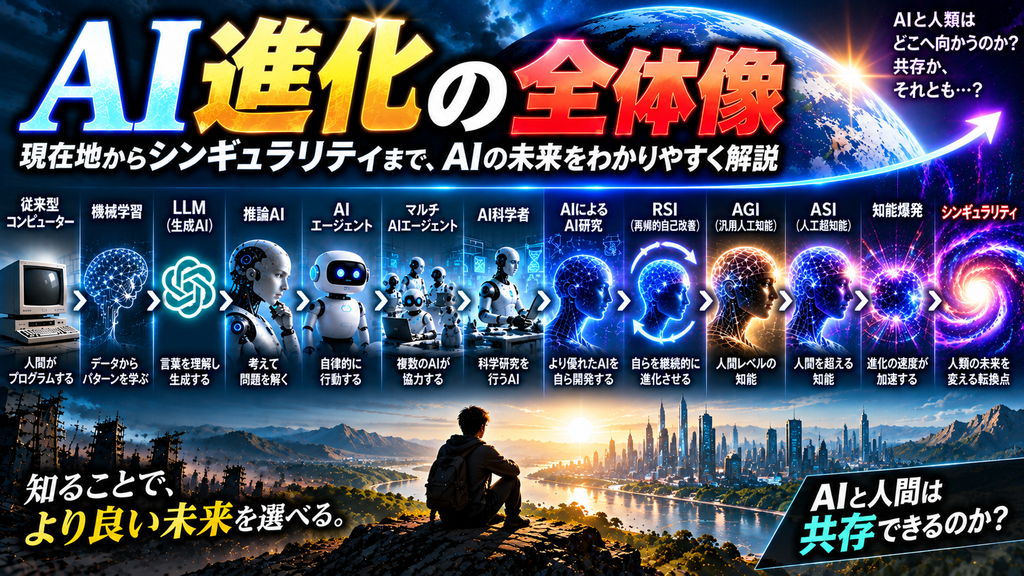
マルチAIエージェントを理解する前に、AIの進化を大きな流れで整理してみましょう。
1.ルールベースAI
人間があらかじめ設定したルールに従って判断するAIです。
例えば、
「条件Aなら処理Bを実行する」
というように、人間が決めた規則に沿って動きます。
条件が明確な作業には強い一方、想定されていない状況への柔軟な対応は苦手です。
2.機械学習AI
大量のデータからパターンや傾向を学習するAIです。
画像認識、迷惑メール判定、需要予測、推薦システムなど、さまざまな分野で利用されるようになりました。
3.深層学習AI
ニューラルネットワークを多層化したDL(Deep Learning:深層学習)によって、画像、音声、文章などの複雑なデータを扱えるようになりました。
現在の生成AIを支える重要な技術の一つです。
4.生成AI
文章、画像、音声、動画、プログラムなど、新しいコンテンツを生成するAIです。
文章を扱う生成AIでは、LLM(Large Language Model:大規模言語モデル)などの基盤モデルが重要な役割を果たしています。
5.AIエージェント
AIエージェントでは、AIは質問に答えるだけではありません。
目的を与えられると、その目的を達成するために、
計画 → 情報収集 → ツール利用 → 実行 → 確認 → 修正
といった複数の工程を進めます。
6.マルチAIエージェント
さらに複数のAIエージェントを組み合わせ、役割を分担させます。
一つのAIがすべてを担当するのではなく、
企画AI、調査AI、分析AI、実行AI、検証AI、管理AI
などが協力して仕事を進めるわけです。
AIの進化を非常に単純化すると、
ルールベースAI → 機械学習 → 深層学習 → 生成AI → AIエージェント → マルチAIエージェント
という流れで捉えることができます。
ただし、これは古い技術が完全に新しい技術へ置き換わったという意味ではありません。
実際のAIシステムでは、ルールベースの処理、機械学習、生成AI、AIエージェントなどが組み合わされています。
AIエージェントとは何か?
通常のチャットAIでは、
人間 → 質問 → AI → 回答
という流れが基本です。
一方、AIエージェントでは、人間が細かな作業を一つずつ指示するのではなく、達成してほしい目的を与えます。
例えば、
「あるテーマについて詳しい調査レポートを作ってください」
という仕事を与えたとします。
通常のチャットAIなら、その場で文章を生成することが中心です。
しかしAIエージェントであれば、
- 調査計画を作る
- 必要な情報を検索する
- 複数の資料を読む
- 情報を比較する
- 必要に応じてデータを分析する
- レポートを書く
- 内容を確認する
- 問題があれば修正する
といった複数の工程を連続して実行できます。
つまりAIエージェントとは、
目的を達成するために、必要な行動を選択しながら複数の作業を進めるAIシステム
と考えると分かりやすいでしょう。
2026年現在、AIエージェントは研究だけの技術ではなくなっています。
文章作成、ソフトウェア開発、データ分析、顧客対応、社内情報検索など、範囲を限定した業務では実用化が進んでいます。
ただし、AIへ仕事を任せれば何日間でも完全に自律して正しく働き続けられる、という段階に達したわけではありません。
AIは途中で、
- 誤った判断をする
- 目的から外れる
- 存在しない情報を作る
- 不適切なツールを使用する
- 同じ作業を繰り返す
といった問題を起こす可能性があります。
そのため現在のAIエージェントでは、人間による確認、アクセス権限、停止条件、ログ、評価システムなどが重要になります。
マルチAIエージェントとは?
マルチAIエージェントとは、複数のAIエージェントを組み合わせ、協力させる仕組みです。
人間の会社を考えてみましょう。
一人の社員が、
- 企画
- 市場調査
- データ分析
- プログラミング
- 文章作成
- 品質管理
- 最終判断
まですべて担当するより、専門性を持つ複数の社員が仕事を分担した方が効率的な場合があります。
AIでも同じ発想ができます。
例えば、次のようなAIチームです。
| AIの役割 | 主な仕事 |
|---|---|
| 企画AI | 問題を分析して計画を作る |
| 調査AI | Webや論文などから情報を集める |
| 分析AI | データや資料を分析する |
| 実行AI | コードやシミュレーションを実行する |
| 執筆AI | 結果を文章として整理する |
| 検証AI | 間違い、矛盾、根拠不足を探す |
| 管理AI | 全体を統括し、次の作業を決める |
一つの大きな仕事を細かな課題へ分解し、それぞれを専門的なAIに担当させます。
これがマルチAIエージェントの基本構造です。
ただし、ここで重要なのは、AIエージェントの数=AIモデルの数とは限らないことです。
同じ基盤モデルに対して、
- 異なる指示
- 異なる役割
- 異なるツール
- 異なるデータ
- 異なるアクセス権限
を与え、複数のエージェントとして動かすこともできます。
マルチAIエージェントはどう動くのか?
典型的なマルチAIエージェントは、次のような循環で仕事を進めます。
人間
↓
目的を設定
↓
管理・計画AI
↓
タスクを分解
↓
┌────────┬────────┬────────┐
│ 調査AI │ 分析AI │ 実行AI │
└────────┴────────┴────────┘
↓
検証AI
↓
結果を統合
↓
問題があれば再計画
↓
最終結果
↓
人間が確認
重要なのは、一度答えを生成して終わるのではなく、
計画 → 分担 → 実行 → 検証 → 統合 → 再計画
というループを作れることです。
大学の研究室で考えると分かりやすい
マルチAIエージェントを理解するには、大学の研究室をイメージすると分かりやすくなります。
研究室には教授がいて、その下に研究員や大学院生がいます。
教授が、
「この新しい現象について研究しよう」
と研究テーマを決めたとしましょう。
教授自身がすべての論文を読み、すべての計算をし、すべての実験をする必要はありません。
研究メンバーへ、
「あなたは先行研究を調べてください」
「あなたはこの仮説を検証してください」
「あなたはシミュレーションをしてください」
「あなたは反例を探してください」
と仕事を分担できます。
そして最後に、それぞれの結果を比較します。
例えば、
- 方法Aは失敗した
- 方法Bは有望だった
- シミュレーションでは仮説を支持した
- しかし特殊な条件では反例が見つかった
という報告が集まったとします。
教授は、
「方法Bを修正し、反例が見つかった条件を詳しく調べよう」
と次の研究方針を決めます。
このような研究室の構造をAIで再現するのが、マルチAIエージェントによる仮想的なAI研究室です。
「教授AI+研究員AI」はどう動くのか?
もう少し具体的に考えてみましょう。
人間が「教授AI」に難しい数学問題を与えたとします。
ステップ1|教授AIが研究計画を作る
教授AIは、いきなり最終回答を書くのではなく、問題を複数の研究課題へ分解します。
例えば、
- 既存の定理を調べる
- 方法Aで証明する
- 方法Bで証明する
- 数値計算で確認する
- 反例を探索する
という計画を作ります。
ステップ2|複数のAIへ仕事を割り振る
次に、それぞれの仕事を別のAIへ任せます。
研究員AI A
関連する理論や先行研究を調査します。
研究員AI B
方法Aによる証明を試します。
研究員AI C
まったく別の方法から問題を考えます。
計算AI
プログラムを書き、数値計算を行います。
反例探索AI
仮説が成立しないケースを探します。
これらのAIは、システム設計や計算資源が許せば並行して作業できます。
ステップ3|検証AIが確認する
研究員AIが答えを出しても、そのまま正しいと判断する必要はありません。
検証AIが、
- 計算は正しいか
- 論理が飛躍していないか
- 引用した情報は実在するか
- 条件を見落としていないか
- 反例は存在しないか
などを確認します。
ただし、検証AIそのものも間違える可能性があります。
そのため重要な結果では、
- 別のAIモデル
- 実際のコード実行
- 数学的検証
- 一次資料
- 人間の専門家
などを組み合わせて確認する必要があります。
ステップ4|教授AIが結果を統合する
最後に教授AIが各AIの報告を比較します。
そして、
「方法Bが最も有望だが、特殊ケースに問題がある。そこを追加調査しよう」
と判断します。
再びAIへ作業を割り振れば、
計画 → 実行 → 検証 → 改善
という研究サイクルを繰り返せます。
なぜ一つの高性能AIではなく、複数のAIを使うのか?
「非常に賢いAIを一つ作ればよいのでは?」
という疑問もあります。
実際、単純な仕事では一つのAIの方が効率的な場合があります。
マルチAIエージェントには、AI同士を調整する追加コストが発生するからです。
それでも複数のAIを利用する理由があります。
1.並列化できる
10種類の方法を一つずつ試すより、複数のAIが同時に異なる方法を試した方が、条件によっては短時間で多くの候補を探索できます。
2.専門化できる
すべてを同じAIに担当させる必要はありません。
例えば、
- 調査
- プログラミング
- 数学
- データ分析
- 文章作成
- セキュリティ検査
などに役割を分けられます。
3.異なるモデルを使い分けられる
簡単な作業には低コストの小型モデル、難しい推論には高性能モデル、専門分野には専用モデルという使い分けも考えられます。
4.相互検証できる
例えば、
AI Aが回答 → AI Bが批判 → AI Cが再検証
という構造にできます。
一つのAIが自分自身の答えを確認するより、異なる役割やモデルを利用することで、問題を発見できる場合があります。
ただし、複数のAIを使えば自動的に正確になるわけではありません。
同じ情報や同じモデルに依存していれば、複数のAIが同じ間違いを共有する可能性もあります。
AIを1万体動かせば1万倍賢くなるのか?
ここはマルチAIエージェントを考えるうえで重要です。
AIの数を増やしても、知能や成果がそのまま人数分増えるわけではありません。
例えば、同じモデルを1,000体動かしても、全員が同じ誤った前提を持っていれば、1,000体が同じ間違いをする可能性があります。
また、AIの数が増えるほど、
- 誰にどの仕事を任せるのか
- 誰の結果を信用するのか
- 発見をどう共有するのか
- 矛盾をどう解決するのか
- 重複した作業をどう防ぐのか
- 全体の進捗をどう把握するのか
という問題が大きくなります。
人間の会社でも、社員を10倍にすれば生産性が10倍になるとは限りません。
AIでも同じです。
マルチAIエージェントの性能を単純化して考えるなら、
システム全体の能力 ≠ AIの数だけで決まる
ということです。
重要なのは、
AIの能力 × 役割分担 × 協調効率 × 検証能力 × 利用できるツール・データ
です。
さらに、
- 計算資源
- 電力
- 通信量
- API利用料
- データ品質
- セキュリティ
- 監視コスト
も考える必要があります。
2026年、マルチAIエージェントはどこまで実現しているのか?
2026年9月時点のAI開発を大きく整理すると、主に三つの方向があります。
1.基盤モデルの高性能化
文章だけでなく、画像、音声、動画、コードなど、複数種類の情報を扱うAIが発展しています。
推論能力やツール利用能力も重要な開発分野になっています。
2.AIエージェント化
AIが単に回答を生成するだけでなく、
- Web検索
- ファイル操作
- コード実行
- データ分析
- API利用
- 業務システム操作
などを組み合わせ、複数ステップの仕事を進める方向です。
3.マルチAIエージェント化
さらに、複数のAIやツールを組み合わせます。
例えば、
- 調査担当
- 分析担当
- 実行担当
- レビュー担当
- 管理担当
というように仕事を分けます。
現時点で特に現実的なのは、範囲が明確に定義された仕事です。
例えば、
- 社内文書を検索して回答する
- 会議を要約してタスクを整理する
- プログラム作成とテストを支援する
- 複数資料を比較してレポートを作る
- 問い合わせを分類する
- データを分析して候補を提示する
といった用途です。
一方、
AIが自分で長期目標を設定し、予算や人員を管理し、重要な意思決定を行いながら、長期間にわたって完全自律で組織を運営する
というレベルが一般化したわけではありません。
現在のマルチAIエージェントは、
人間が目的、権限、利用可能なデータ、ツール、停止条件などを設定し、その範囲内で複数のAIが協力するシステム
として捉えるのが現実に近いでしょう。
大学の研究室と「AI研究室」を比較
マルチAIエージェントが発展すると、研究活動の一部を複数のAIに担当させる「AI研究室」のような仕組みが考えられます。
大学の研究室と比較してみましょう。
| 比較項目 | 大学の研究室 | AI研究室 |
|---|---|---|
| メンバー | 教授、研究員、大学院生など | 管理AI、調査AI、分析AI、検証AIなど |
| 作業速度 | 人間の時間に制約される | 高速処理・並列化が可能 |
| 文献調査 | 読む時間が必要 | 大量の資料を短時間で処理しやすい |
| 専門性 | 経験、直感、暗黙知を活用できる | 学習データや利用可能な情報に依存 |
| 計算 | 人間が設計して実行 | コード生成・実行を自動化しやすい |
| 現実の実験 | 設備・材料を利用できる | ロボット等との接続が必要 |
| 倫理判断 | 人間が社会的背景を考慮できる | 人間が設定したルール・評価に依存 |
| 稼働時間 | 人間の生活時間に左右される | システム上は長時間稼働可能 |
| コスト | 人件費、研究費、設備費 | 計算資源、電力、利用料、開発費 |
| 責任 | 研究者・組織が負う | 運用者・開発者など人間側の責任設計が必要 |
大学の研究室の強み
人間の研究者には、
- 問題の社会的意味を考える
- 「何を研究する価値があるか」を考える
- 長年の経験や直感を使う
- 想定外の実験結果へ柔軟に対応する
- 倫理や安全性を議論する
- 人間同士の議論から発想を生み出す
という強みがあります。
特に、評価方法そのものが確立していない未知の研究では、人間の問題意識が重要です。
AI研究室の強み
一方、AIには、
- 大量の資料を処理する
- 多数の候補を生成する
- 複数の仮説を並行して試す
- コードを書く
- シミュレーションを実行する
- 同じ条件の検証を繰り返す
- 長時間処理する
といった強みがあります。
そのため、AI研究室が人間の研究室をそのまま置き換えるというより、
人間が研究テーマや重要な判断を担当し、AIが探索・調査・計算・候補生成・検証を高速化する
という組み合わせが重要になると考えられます。
マルチAIエージェントから「AI科学者」へ
マルチAIエージェントと特に相性がよい可能性がある分野が、科学研究です。
研究には、
文献調査 → 仮説生成 → 実験計画 → プログラミング → シミュレーション → データ分析 → 検証 → 論文作成
という多くの工程があります。
これらを複数のAIへ分担させれば、「AI研究チーム」に近い仕組みを構築できます。
さらにAIがロボットや実験装置と接続されれば、
AIが仮説を作る → 実験を計画する → 装置が実験する → AIが結果を分析する → 次の実験を考える
という閉じた研究サイクルも考えられます。
ただし、現実の科学研究では、
- 研究テーマの価値
- 実験の安全性
- 再現性
- データ品質
- 倫理
- 法規制
- 研究不正の防止
など、単純な自動化では解決できない問題があります。
特に生命科学、化学、医療などでは、AIが提案した実験を無条件で実行することは危険です。
実験設備や危険物、個人情報などへのアクセスは厳しく管理する必要があります。
最大の転換点|AIがAIを研究すると何が起きるのか?
さらに重要なのが、AIそのものをAIの研究対象にすることです。
例えば教授AIに、
「現在のAIの推論能力を改善してください」
という研究テーマを与えたとします。
すると、
調査AI
既存のAI研究を調査する。
設計AI
新しいアルゴリズムや改善方法を考える。
実装AI
コードを書く。
実験AI
新しい方法を実験する。
評価AI
既存手法と性能を比較する。
検証AI
問題点や安全性を確認する。
教授AI
結果を統合し、次の研究テーマを決める。
というAI研究チームを構成できます。
もし、この研究によってAIの能力が改善すれば、次の研究では、改善されたAIを研究者として利用できる可能性があります。
つまり、
AIがAIを研究する
↓
より高性能なAIが作られる
↓
そのAIが次のAI研究を支援する
↓
さらに研究速度が上がる可能性がある
という循環です。
RSI(再帰的自己改善)とは?
この議論の先にある概念が、RSI(Recursive Self-Improvement:再帰的自己改善)です。
RSIとは、簡単にいえば、
AIが自分自身の設計や学習方法などを改善し、その改善されたAIがさらに次の改善を進める
という考え方です。
ただし、現在のAIによるAI開発支援と、完全なRSIは区別する必要があります。
AIが、
- コードを書く
- 論文を調査する
- 実験案を作る
- ベンチマークを実行する
- モデルを比較する
ことができても、それだけで自律的かつ継続的な自己改善が成立するとは限りません。
実際のAI開発には、
- 学習データ
- 大規模な計算資源
- 評価基準
- 実験環境
- 再現性確認
- セキュリティ
- 安全性評価
- 人間による意思決定
などが必要だからです。
したがって、
「AIがAI開発を支援する」ことと「AIが制約なく自己改善を続ける」ことは同じではありません。
マルチAIエージェントはAGIへの道なのか?
マルチAIエージェントがそのままAGIになるとは限りません。
AGI(Artificial General Intelligence:汎用人工知能は、一般に、特定の作業だけでなく幅広い分野の課題へ柔軟に対応できる高度なAIを表す言葉として使われます。
ただし、AGIには世界共通の厳密な定義があるわけではありません。
将来の高度なAIには、大きく二つの可能性を考えられます。
一つの非常に高性能なAI
一つのモデルそのものが、幅広い問題を解決できるようになる方向です。
多数のAIによる巨大な知能システム
複数の専門AIが協力し、システム全体として高度な能力を実現する方向です。
つまり未来の高度AIは、
「一人の天才AI」
だけではなく、
「多数のAIが協力する巨大な知能システム」
として発展する可能性もあります。
人間社会も同じです。
科学者、技術者、医師、企業、大学、行政など、多数の人間や組織が情報を交換することで、社会全体として巨大な知的活動を行っています。
AIでも、個々のモデルの能力だけではなく、AI同士をどのように接続し、協調させるかが重要になる可能性があります。
マルチAIエージェントのメリット
ここまでを整理すると、主なメリットは次の通りです。
並列処理
複数の課題を同時に進められます。
専門化
役割ごとに異なるAI、モデル、ツールを利用できます。
相互検証
一つのAIの結果を別のAIに検証させられます。
大規模な探索
多数の仮説や候補を比較できます。
自動化範囲の拡大
一つの回答ではなく、複数工程からなる仕事を自動化できます。
モデルの使い分け
簡単な仕事は小型AI、難しい仕事は高性能AIという構成にできます。
マルチAIエージェントのデメリットとリスク
マルチAIエージェントにはメリットだけでなく、新しいリスクもあります。
1.誤りが連鎖する
一つのAIが誤った情報を出すと、その情報を受け取った別のAIも誤った判断をする可能性があります。
2.AI同士が同じ間違いをする
同じモデルやデータに依存していれば、複数のAIが同じ誤りを共有する可能性があります。
3.システムが複雑になる
AIが増えるほど、
- 誰が何をしたのか
- なぜその判断になったのか
- どこで問題が発生したのか
を追跡することが難しくなります。
4.権限の問題
AIに、
- メール送信
- ファイル削除
- データベース更新
- プログラム実行
- 支払い
- 外部公開
などの権限を与える場合、誤操作の影響が大きくなります。
5.情報漏えい
一つのAIが取得した個人情報や企業秘密が、他のAIへ不必要に共有される可能性があります。
6.セキュリティ攻撃
一つのAIが攻撃者に操作された場合、そのAIを経由して別のAIやシステムへ影響が広がる可能性があります。
7.コスト増加
AIの数を増やせば、
- GPUなどの計算資源
- API利用料
- 電力
- 通信
- データ保存
- 監視
のコストも増えます。
マルチAIエージェントを安全に使うには?
重要なのは、AIモデル単体の安全性だけではありません。
AIチーム全体の能力と権限を管理することが必要です。
代表的な対策として、
- AIの権限を必要最小限にする
- 重要操作には人間の承認を要求する
- AI同士の通信を記録する
- 操作ログを残す
- 外部システムへのアクセスを制限する
- 独立した検証機能を用意する
- AIが停止する条件を設定する
- 異常時に人間が強制停止できるようにする
- 本番環境とテスト環境を分離する
といった設計が考えられます。
特に重要なのがHuman in the Loop(人間参加型)の考え方です。
例えば、
AIが提案 → AIが検証 → 人間が承認 → 実行
という構造にすれば、重要な操作をAIだけで完結させずに済みます。
AIの自律性が高くなるほど、
「AIに何ができるか」だけでなく「AIに何を許可するか」
が重要になります。
2026年時点のAIリスク対策
AIのリスク対策は、大きく分けると三つの層で進んでいます。
技術
- AIモデルの評価
- 危険な出力の検出
- アクセス権限管理
- 監査ログ
- サンドボックス
- レッドチーム
- セキュリティ検査
などです。
レッドチームとは、システムを意図的に攻撃したり、想定外の使い方を試したりして弱点を発見する検証活動です。
企業・組織の運用
- 重要な判断には人間を関与させる
- 個人情報や機密情報へのアクセスを制限する
- AIが利用できるツールを制限する
- 問題発生時の停止手順を作る
- 責任者を明確にする
といった対策です。
法律・制度
AIのリスクに応じて、規制やガイドラインを整備する動きも進んでいます。
ただし、AIに対する規制や制度は国や地域によって異なり、世界共通のルールが完成しているわけではありません。
今後3年間のAI開発はどうなるのか?
ここからは、2026年9月から2029年ごろまでの約3年間を考えてみます。
もちろん、AIの進歩は、
- 新しい技術
- 半導体
- データセンター
- 電力
- 投資
- 規制
- 社会的受容
などによって大きく変化します。
したがって、以下は確定した未来ではなく、現在の技術動向から考えられるシナリオです。
1年目|AIエージェントが業務へ定着
最初の段階では、AIエージェントが企業や研究機関の限定された業務へさらに組み込まれる可能性があります。
例えば、
- 社内情報検索
- データ整理
- 顧客対応
- プログラム作成
- テスト
- 会議後のタスク整理
- レポート作成
などです。
完全自動化より、
AIが作業 → 人間が重要部分を確認 → AIが実行
という人間参加型の運用が重要になるでしょう。
2年目|マルチAIエージェントと専門AIの拡大
次の段階では、一つのAIにすべてを任せるのではなく、
調査 → 分析 → 実行 → 検証 → 管理
を複数のAIへ分担する構成が広がる可能性があります。
さらに、
- 簡単な仕事 → 小型モデル
- 専門的な仕事 → 専門モデル
- 難しい判断 → 高性能モデル
という使い分けも重要になります。
すべての仕事に最も大きなAIを利用するのではなく、性能、速度、コストのバランスを取るAIシステムが増えていく可能性があります。
3年目|AIによるAI開発がさらに進む可能性
さらに先では、AIがソフトウェアだけでなく、AI開発そのものを支援する割合が増える可能性があります。
例えば、
- 研究論文の調査
- 学習データの整理
- コード生成
- テスト
- ベンチマーク作成
- 性能評価
- 改善案の提案
- バグ探索
- セキュリティ検査
などです。
AI研究の一部をAIが担当することで、研究開発サイクルが短縮される可能性があります。
ただし、これはAIが自由に自分自身を改造し続けることを意味しません。
計算資源、安全性、評価、再現性、人間による承認などが引き続き重要です。
今後3年間で重要になる5つの課題
1.信頼性
AIが答えを出すだけでなく、
- 根拠を確認できる
- 不確実性を扱える
- 間違いを検出できる
- 再現できる
ことが重要になります。
2.自律性と制御のバランス
AIが長時間自律して働けるほど便利になります。
一方、強い権限を持つAIが間違えた場合、影響も大きくなります。
そのため、
どこまでAIに任せ、どこから人間が承認するのか
という設計が重要です。
3.計算資源とコスト
多数のAIを動かすには、
- 半導体
- データセンター
- 電力
- 通信
- 冷却設備
などが必要です。
AIの性能だけでなく、効率化、小型化、コスト削減も重要な競争領域になります。
4.人間の仕事と教育
AIによって一部の定型作業が自動化される一方、
- AIへ仕事を設計する
- AIを監督する
- AIの結果を評価する
- AIでは判断できない問題を扱う
といった仕事の重要性が高まる可能性があります。
教育や職業訓練も変化するでしょう。
5.ルールと責任
AIが複数のシステムを横断して仕事をするようになると、
「AIが間違えた場合、誰が責任を負うのか?」
という問題がさらに重要になります。
開発企業、AIサービス提供者、導入企業、運用担当者など、それぞれの責任範囲を明確にする必要があります。
2029年ごろ、AIはどのような存在になっているのか?
3年後のAIは、現在のようにチャット画面で質問へ回答するだけの存在から、
複数のツールや業務システムを使い分ける「デジタルな仕事仲間」
へさらに近づいている可能性があります。
個人向けでは、
- 情報整理
- 調査
- 学習
- 文章作成
- スケジュール管理
- 各種手続きの支援
などを複数ステップで支援するAIが考えられます。
企業では、
- 営業AI
- 経理AI
- 人事AI
- 開発AI
- 顧客対応AI
- セキュリティAI
などを組み合わせ、それらを統括するAIが仕事を調整する構成も考えられます。
研究機関では、
文献調査 → 仮説生成 → シミュレーション → 分析 → 検証
という研究サイクルの一部が大幅に高速化される可能性があります。
ただし、AIが人間の判断を完全に不要にするとは限りません。
むしろAIが大量の候補を作れるようになるほど、
どの候補に価値があるのか、どのリスクを許容するのか、社会として何を目指すのか
を判断する人間の役割が重要になる可能性があります。
まとめ|AIは「一人の助手」から「組織」へ進化する
マルチAIエージェントの本質は、AIを大量に動かすことではありません。
重要なのは、
複数のAIが役割を持ち、仕事を分担し、情報を共有し、互いの結果を検証しながら、一つの目的に向かって協力すること
です。
現在の生成AIを「優秀な一人の助手」とするなら、マルチAIエージェントは「AIで構成されたチーム」に近い存在です。
2026年9月時点では、限定された業務や研究支援へのAIエージェント導入が進む一方、完全自律型のAI組織が人間の企業や研究機関を全面的に置き換えた段階ではありません。
特に重要なのは、
- AIがどれだけ長時間安定して働けるのか
- 複雑な仕事を適切に分解できるのか
- AI同士が効率よく協力できるのか
- AI同士が互いの間違いを発見できるのか
- AIへ与える権限を安全に管理できるのか
- 人間がAIの行動を監督・停止できるのか
- AIがAI研究そのものをどこまで加速できるのか
という点です。
今後のAIの進化は、
チャットAI
↓
AIエージェント
↓
マルチAIエージェント
↓
AI研究チーム
↓
AI科学者
↓
AIによるAI研究
という方向へ進む可能性があります。
その先に再帰的自己改善やAGIの議論がありますが、現在のAIエージェントやAI開発支援からそこまでの間には、技術面、安全面、経済面、制度面で多くの課題があります。
したがって、AIの未来を考えるうえで注目すべきなのは、単純な「AIの数」やベンチマーク上の性能だけではありません。
一つのAIがどれほど賢いのか。
そして、
多数のAIを組み合わせたとき、システム全体としてどれほど大きな能力を安全かつ安定して発揮できるのか。
この二つを分けて考える必要があります。
マルチAIエージェントは、AIを「回答するソフトウェア」から「協力して仕事を進めるシステム」へ変える重要な技術です。
そしてAIの能力が高くなるほど、最後に重要になるのは、
何をAIに任せるのか。
どこで人間が確認するのか。
誰が責任を持つのか。
そして、問題が起きたときに確実に止められるのか。
という設計です。
AIの未来は、AIそのものの性能だけで決まるわけではありません。
人間とAI、そしてAI同士が、どのようなルールのもとで協力するのか。
マルチAIエージェントの進化を見ることは、その未来を考える重要な手がかりになるでしょう。