2026年10月2日
AIは急速に進化しています。
少し前まで、AIは画像を分類したり、文章を翻訳したりする「特定の仕事をする技術」というイメージが中心でした。
しかし現在は、文章や画像を生成するAIだけでなく、複雑な問題を考えるAI、目的を与えると複数の作業を進めるAIエージェント、複数のAIが協力するマルチAIエージェントなどが登場しています。
さらに将来については、
AI科学者 → AIによるAI研究 → RSI → AGI → ASI → 知能爆発 → シンギュラリティ
という可能性まで議論されています。
ここで重要になるのが、安全対策をいつ始めるのかという問題です。
AIが人間よりはるかに賢くなってから安全対策を考えればよいのでしょうか。
そうとは限りません。
AIの能力が高くなるほど、与えられる権限や仕事の範囲も大きくなります。そして、AIが自律的に行動したり、複数のAIが協力したり、AI自身がAI研究を行ったりするようになれば、リスクの性質そのものが変わる可能性があります。
そこでこの記事では、AIの進化を、
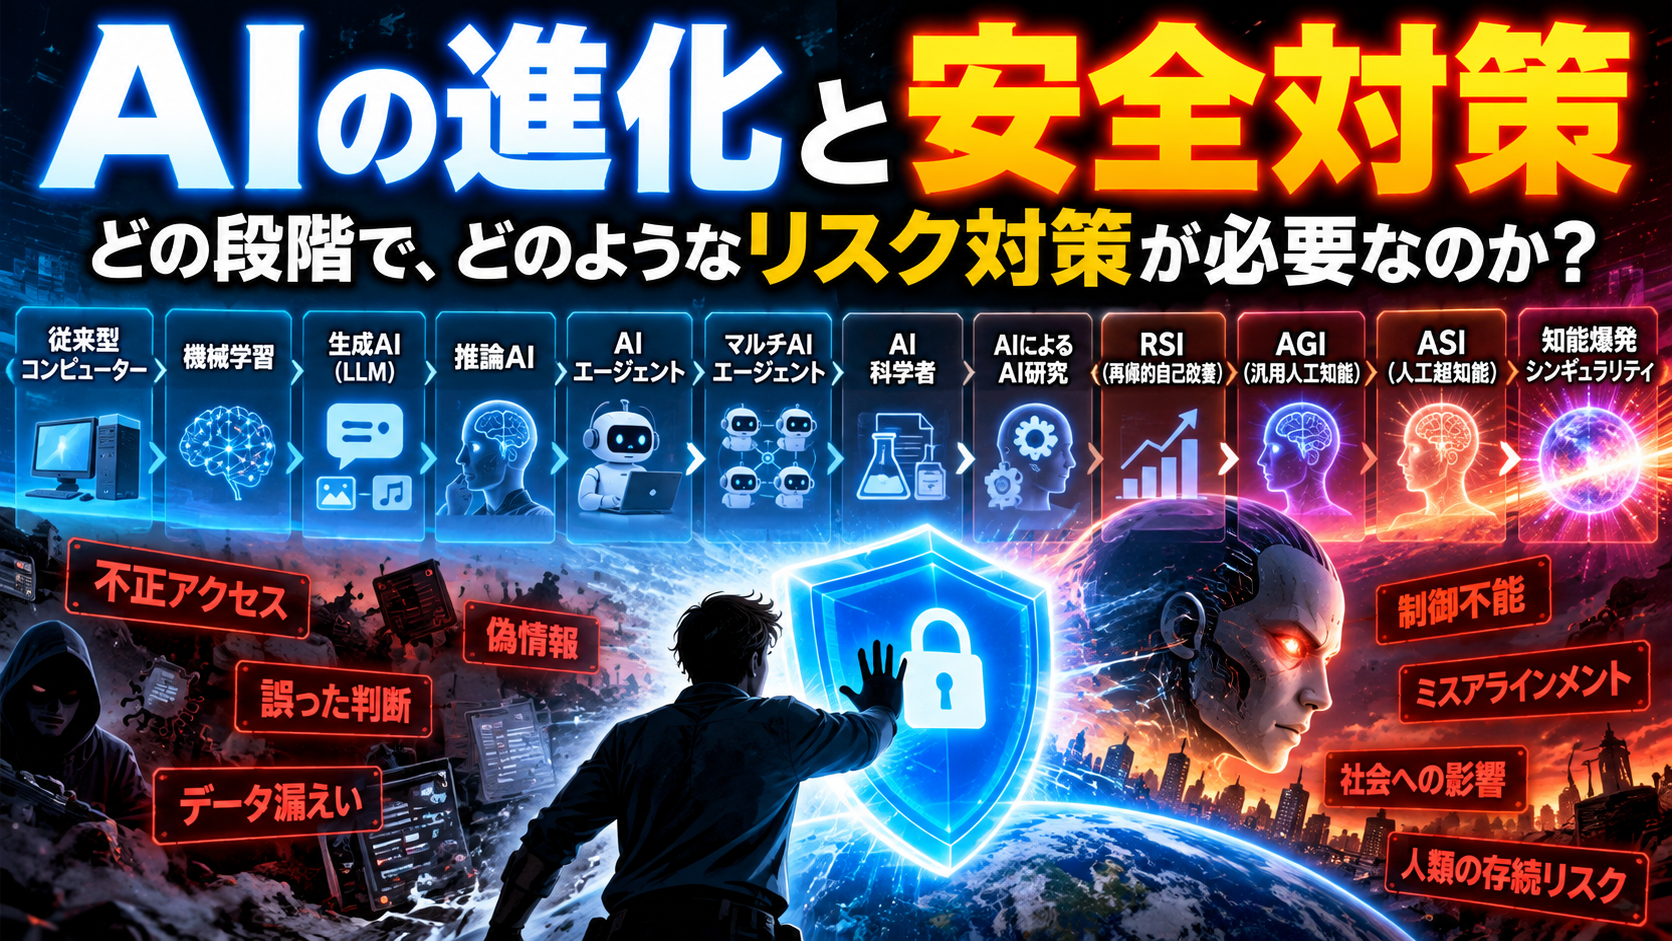
従来型コンピューター → 機械学習 → LLM・生成AI → 推論AI → AIエージェント → マルチAIエージェント → AI科学者 → AIによるAI研究 → RSI → AGI → ASI → 知能爆発・シンギュラリティ
という流れで整理し、それぞれの段階で考えられる主なリスクと必要な対策を、AI初心者にも分かるように解説します。
なお、これはAIが必ずこの順番で進化するという意味ではありません。
現在すでに実用化されている技術と、将来の可能性として議論されている概念を区別して考えることが重要です。
第1段階|従来型コンピューター
従来型コンピューターでは、人間がプログラムを書き、コンピューターがその命令を実行します。
例えば、
「AならBを実行する」
「この数字を計算する」
「このデータを保存する」
といった処理です。
この段階では、基本的にコンピューター自身が目的を考えるわけではありません。
しかし、安全対策が不要だったわけではありません。
現在のAI安全対策の土台となる考え方の多くは、従来のコンピューターセキュリティから続いています。
主なリスク
- 不正アクセス
- コンピューターウイルスやマルウェア
- データの盗難・改ざん・消失
- プログラムのバグ
- システム障害
- 内部関係者による不正利用
- 権限設定のミス
主な対策
- ID・パスワードや多要素認証による本人確認
- 利用者ごとのアクセス権限管理
- ファイアウォールやマルウェア対策
- データの暗号化
- バックアップ
- 操作ログの保存
- ソフトウェア更新と脆弱性対策
AI時代になっても、これらの基本対策はなくなりません。
むしろAIがさまざまなシステムを操作するようになれば、従来型のセキュリティはさらに重要になります。
第2段階|機械学習
機械学習では、人間がすべてのルールを書くのではなく、大量のデータからコンピューターにパターンを学習させます。
例えば大量の猫と犬の画像を学習させることで、新しい画像を見たときに「猫か犬か」を判断できるようになります。
ここで安全問題が変化します。
従来型コンピューターでは「プログラムが正しいか」が重要でした。
機械学習では、それに加えて、
「どのようなデータから学習したのか」
が重要になります。
主なリスク
- 学習データの偏りによる不公平な判断
- 誤ったデータによる性能低下
- 個人情報や機密情報の利用
- 学習データへの悪意ある情報の混入
- AIの判断理由が分かりにくい
- 実際の利用環境で予想外の誤りを起こす
主な対策
- 学習データの品質管理
- データの偏りや代表性の確認
- 個人情報の適切な処理
- AIの性能を複数の条件で評価
- 重要判断では人間による確認を行う
- 学習時と実運用時の性能差を継続的に監視する
ここから、「プログラムを安全にする」だけでなく、AIの学習過程や判断結果を安全にするという考え方が必要になります。
第3段階|LLM・生成AI
現在、多くの人が利用している生成AIの中心技術の一つがLLMです。
LLMは「Large Language Model(ラージ・ランゲージ・モデル)」の略で、日本語では「大規模言語モデル」と呼ばれます。
大量の文章などから言語のパターンを学習し、質問への回答、文章作成、要約、翻訳、プログラミングなどを行うAIです。
生成AIは文章だけでなく、画像、音声、動画なども生成します。
ここでAIは、「分類する技術」から「新しい情報を作り出す技術」へ大きく広がりました。
主なリスク
- 事実ではない内容を生成するハルシネーション
- 誤情報や偽情報の大量生成
- 詐欺やなりすましへの悪用
- 個人情報や機密情報の入力・漏えい
- 著作権など知的財産に関する問題
- 偏見や差別的内容の生成
- AIの回答を人間が過信する
- 悪意ある指示によってAIの制限を回避される
主な対策
- 重要情報を一次資料で確認する
- AIの回答をそのまま事実として扱わない
- 個人情報や企業秘密の入力ルールを設ける
- 危険な出力を検出・制限する
- AI利用に関する社内ルールを作る
- 出典や根拠を確認できる仕組みを導入する
- 利用者へのAIリテラシー教育を行う
- 外部から入力される命令やデータを適切に隔離する
生成AIの安全性では、AIだけでなく、利用する人間がAIの限界を理解することも重要です。
第4段階|推論AI
次に重要になるのが、複雑な問題を複数の段階に分けて処理するAIです。
数学、科学、プログラミングなどで、問題を分析し、方法を考え、結果を確認し、失敗すれば別の方法を試す能力が高まっています。
ここでは、単に文章が自然かどうかではなく、問題解決そのものの信頼性が重要になります。
AIが非常に説得力のある説明をしていても、途中の前提や最終的な答えが間違っている可能性があります。
主なリスク
- 複雑な推論の途中で誤りが入る
- 誤った前提からもっともらしい結論を導く
- AIの説明が説得力を持つため、人間が過信する
- 評価テストでは高性能でも、現実の問題では失敗する
- AI自身による確認が誤りを発見できない
主な対策
- 結果を外部データや計算で検証する
- 重要問題では複数の方法で確認する
- 異なるAIや人間の専門家による独立検証を行う
- 結果だけでなく根拠や出典を確認する
- 実際の利用環境に近い条件で性能を評価する
AIが賢く見えるほど、人間側には「疑って確認する能力」が必要になります。
第5段階|AIエージェント
ここから安全問題が大きく変化します。
AIエージェントとは、質問に答えるだけでなく、目的を達成するために計画を立て、ツールを使い、複数の作業を実行するAIシステムです。
例えば、
調査する → ファイルを読む → コードを書く → プログラムを実行する → 結果を確認する → 修正する
という仕事を連続して行います。
AIが「情報を出力する存在」から「行動する存在」へ変わるため、権限管理が非常に重要になります。
主なリスク
- AIが誤った操作を実行する
- ファイルを削除・変更する
- 間違ったメールや情報を外部へ送信する
- 不必要なデータへアクセスする
- 外部からの悪意ある指示に影響される
- 長時間の作業で誤りが蓄積する
- AIが目的を誤って解釈する
- 与えられた権限を想定外の方法で使用する
主な対策
- 必要最低限の権限だけを与える「最小権限」を徹底する
- AIをサンドボックスなど隔離された環境で実行する
- 支払い、削除、公開など重要操作には人間の承認を必要とする
- AIの操作履歴を記録する
- 一定条件で自動停止する仕組みを設ける
- 利用できるツールやデータを制限する
- 長時間タスクでは途中でチェックポイントを設ける
- 異常な操作を監視する
ここで重要になる考え方が、**Human in the Loop(ヒューマン・イン・ザ・ループ)**です。
これは重要な判断や操作の途中に人間を参加させ、AIだけで最終決定させない仕組みです。
第6段階|マルチAIエージェント
複数のAIエージェントが協力すると、「一人のAI」から「AIチーム」へ進みます。
例えば、
企画AIが計画を立てる。
調査AIが情報を集める。
実行AIが作業する。
検証AIが結果を確認する。
管理AIが全体を統括する。
という構成です。
うまく設計すれば、一つのAIだけで処理するより複雑な仕事を分担できます。
しかし、システム全体が複雑になることで新しいリスクも生まれます。
主なリスク
- 一つのAIの誤りが他のAIへ伝わる
- 複数のAIが同じ誤情報を信じる
- AI同士が互いの判断を無批判に承認する
- 誰が最終判断をしたのか分からなくなる
- AI間で機密情報が広がる
- 一つのAIへの攻撃がシステム全体へ波及する
- 多数のAIの行動を人間が監視できなくなる
- AIの数を増やすことで計算資源や費用が増大する
主な対策
- AIごとに役割と権限を分離する
- AI間の通信内容を記録・監視する
- 実行担当と検証担当を分離する
- 重要結果は独立したAIや人間が再確認する
- AI同士が利用できる情報を必要最小限にする
- システム全体を停止できる仕組みを設ける
- AIチーム全体としての能力評価を行う
- 一つのモデルだけに依存しない検証方法を用意する
重要なのは、一体のAIが安全かどうかだけでなく、AIチーム全体として何ができるかを評価することです。
第7段階|AI科学者
AIが文献調査、仮説生成、プログラミング、シミュレーション、データ分析などを行えば、科学研究の多くを支援できます。
将来的には、
仮説を考える → 実験を設計する → 実験する → 結果を分析する → 次の実験を考える
という研究サイクルの自動化がさらに進む可能性があります。
ここで大きく変わるのは、AIが「既存情報を処理する」だけでなく、新しい科学的知識を生み出す側に回る可能性があることです。
主なリスク
- AIが誤った仮説や研究結果を大量に生み出す
- 不十分な検証で研究結果が利用される
- 危険な化学・生物学的研究を提案する
- 実験設備を誤操作する
- 研究不正や架空データを見逃す
- 研究速度に人間の審査が追いつかなくなる
主な対策
- 研究分野に応じてAIのアクセス範囲を制限する
- 危険性の高い実験には人間の承認を必須にする
- 実験結果を独立した方法で再現する
- 現実の実験設備へのアクセスを厳格に管理する
- 研究内容に応じた倫理・安全審査を行う
- AI生成の研究結果であることを追跡できる記録を残す
- 人間の専門家による最終確認を維持する
第8段階|AIによるAI研究
さらに重要なのが、AI科学者の研究対象がAIそのものになる段階です。
AIが、
新しいAI設計を考える。
コードを書く。
実験する。
性能を評価する。
改善案を考える。
というAI開発サイクルへ参加します。
これは非常に大きな転換点になる可能性があります。
なぜなら、AIの能力向上によって、AIを開発する能力そのものが向上する可能性があるからです。
主なリスク
- 能力向上の速度が人間の評価速度を上回る
- 安全性より性能向上が優先される
- 新しいAIに予想外の能力が生まれる
- 評価テストでは発見できない危険能力が生じる
- AI自身が作った複雑な設計を人間が理解できなくなる
- 改良されたAIが不用意に外部へ公開される
主な対策
- 新しいAIを段階的に評価する
- 性能だけでなく危険能力も評価する
- AI開発環境を外部システムから隔離する
- 改良されたモデルの公開や複製を管理する
- 第三者による安全評価を導入する
- AI研究に利用できる計算資源や権限を管理する
- AIが提案した変更を自動的に採用しない
- 安全性評価を通過するまで次の開発段階へ進ませない
ここからは、安全性の研究速度がAI能力の向上速度に負けないことが重要になります。
第9段階|RSI・再帰的自己改善
RSIは「Recursive Self-Improvement(リカーシブ・セルフ・インプルーブメント)」の略で、日本語では「再帰的自己改善」と呼ばれます。
簡単に言えば、
AIがAIを改善する → 改善されたAIがさらにAIを改善する → そのAIがさらに改善する
という循環です。
AIが一度だけAI開発を支援することと、RSIは同じではありません。
RSIで重要なのは、改善された能力が次の改善へ利用され、循環が継続することです。
完全なオープンエンドRSIが実現したことは、現時点で確認されていません。
主なリスク
- 自己改善の速度に人間の監督が追いつかない
- 改良を重ねるうちに安全特性が失われる
- AIの能力が予想以上に急速に上昇する
- 改良されたAIがさらに高度な改良方法を発見する
- 人間が理解できない設計へ変化する
- 停止や制御が難しくなる
主な対策
- 自己改善を無制限に許可しない
- 改良の各段階で安全評価を行う
- 次世代モデルの起動に人間の承認を必要とする
- 計算資源へのアクセスを制御する
- 外部ネットワークや重要設備から隔離する
- 改良前の安全な状態へ戻せる仕組みを設ける
- 自己複製や外部展開を制限する
- RSIが成立する前に停止・監査体制を確立する
第10段階|AGI・汎用人工知能
AGIは「Artificial General Intelligence(アーティフィシャル・ジェネラル・インテリジェンス)」の略で、日本語では「汎用人工知能」と呼ばれます。
特定分野だけではなく、人間が行う幅広い知的作業を高い水準で実行できるAIという意味で使われます。
ただし、AGIに世界共通の厳密な定義はありません。
どの能力をどの程度持てばAGIなのかについては、研究者や企業によって考え方が異なります。
主なリスク
- 幅広い能力を組み合わせた予想外の行動
- 高度なサイバー能力の悪用
- 人間を欺いたり操作したりする能力
- 経済や雇用への急激な影響
- 一部企業や国家への強大な能力の集中
- 軍事・犯罪への悪用
- 人間による監督の限界
- 重要インフラへの影響
主な対策
- AGI級能力を想定した事前評価
- 高度AIへの重要権限の集中を避ける
- モデル本体や開発環境を強力に保護する
- 独立した第三者による評価を行う
- 重大事故や異常行動の報告制度を整備する
- 重要インフラへのアクセスを厳しく管理する
- 国や企業を越えた安全基準を整備する
- 社会・経済への影響に備えた制度を検討する
AGIが実現してから制度を考えるのではなく、AGIに近い能力が確認される前から準備することが重要になります。
第11段階|ASI・人工超知能
ASIは「Artificial Superintelligence(アーティフィシャル・スーパーインテリジェンス)」の略で、日本語では「人工超知能」と呼ばれます。
一般には、科学、数学、プログラミング、研究、戦略立案など幅広い知的領域で、人類最高レベルの専門家を大幅に上回る仮想的なAIを意味します。
現時点でASIの存在が確認されているわけではありません。
もしASIが実現すれば、安全問題の難しさは大きく変わる可能性があります。
管理されるAIの方が、管理する人間よりはるかに高い問題解決能力を持つ可能性があるからです。
主なリスク
- 人間による監視や制御を回避する能力
- 人間の意図とAIの目標がずれる「ミスアラインメント」
- 人間を説得・操作する能力の高度化
- サイバー空間や経済システムへの大規模な影響
- 自己複製や能力拡張
- 権力や資源の極端な集中
- 人間社会が重要な意思決定権を失う
- 最悪の場合、人類規模の破局的リスク
主な対策
- AIの目標を人間の意図と整合させるアラインメント研究
- 強力なAIを隔離・制限できる技術
- 複数の独立した監視・検証システム
- AIに重要権限を一括して与えない仕組み
- モデル・計算資源・データセンターの高度なセキュリティ
- 国際的な監視・情報共有体制
- 高度AIに関する重大事故への緊急対応体制
- 人間社会が最終的な統治権限を維持する制度設計
重要なのは、ASIが誕生してからASIに安全対策を考えてもらう、という方法だけに依存しないことです。
高度な制御技術は、それを必要とするAIが登場する前に研究しておく必要があります。
第12段階|知能爆発とシンギュラリティ
RSIによって、
AIの能力向上 → AI研究能力の向上 → さらに速い能力向上
という循環が加速すれば、「知能爆発」が起こる可能性があります。
これは1965年に数学者I・J・グッドが論じた考え方につながります。
さらに、AIや科学技術の進歩が非常に速くなり、それまでの社会や技術の延長線から未来を予測することが困難になる転換点が、「シンギュラリティ」と呼ばれます。
ただし、知能爆発もシンギュラリティも、現時点で確認された出来事ではありません。
半導体、電力、データ、製造設備、ロボット、実験環境などが能力向上の制約になる可能性もあります。
主なリスク
- AI能力の変化に安全評価が追いつかない
- 社会制度や法律の対応が間に合わない
- 経済・軍事・科学技術が短期間で大きく変化する
- 高度AIの行動を人間が理解できなくなる
- 一度の失敗が世界規模の影響を持つ
- 人間が重要な意思決定を取り戻せなくなる可能性
- 最悪の場合、人類の存続に関わる破局的リスク
主な対策
- 知能爆発が起きる前提も含めた安全研究
- 高度AIの能力向上を継続的に監視する
- 危険能力が確認された場合の停止基準を事前に決める
- 高性能AIが利用できる計算資源を把握・管理する
- 国際的な事故報告・情報共有体制を構築する
- 緊急時に各国・企業が協力できる仕組みを作る
- AIに依存しすぎない重要インフラを維持する
- 人間の意思決定権と社会の回復力を維持する
AI安全対策で重要なのは「能力」と「権限」を分けて考えること
AIの危険性を考えるとき、単純に「どれだけ賢いか」だけを見るのは十分ではありません。
例えば非常に高性能なAIでも、
インターネットへ接続できない、プログラムを実行できない、お金を使えない、外部へ連絡できない、重要設備を操作できない
という環境なら、現実世界への影響は限定できます。
反対に、それほど高性能でないAIでも、
企業システム、銀行口座、クラウド、メール、ロボット、工場
などへ広い権限を持てば、事故の影響は大きくなる可能性があります。
そのため、安全性は、
AIの能力 × 自律性 × 権限 × 接続範囲 × コピー数 × 稼働時間
という複数の要素で考える必要があります。
「賢いAIだから危険」「まだAGIではないから安全」という単純な二択ではありません。
安全対策はいつまでに必要なのか
AIの進化と安全対策を整理すると、基本原則は非常にシンプルです。
安全装置が必要になる能力をAIが獲得してから作るのではなく、その能力を獲得する前に準備する。
例えば、
AIエージェントが普及してから権限管理を考えるのではなく、その前に最小権限や承認制度を準備する。
マルチAIエージェントが大規模化してから監査方法を考えるのではなく、その前に通信記録や停止機能を作る。
AIがAI研究を高速化してから危険能力評価を考えるのではなく、その前に評価基準を整備する。
RSIが始まってから自己改善を止める方法を研究するのではなく、その前に制御方法を確立する。
ASIが誕生してから国際協力を始めるのではなく、その前から協力体制を作る。
という考え方です。
AIの安全対策は「ブレーキ」だけではない
AI安全という言葉から、「AIを止めるための技術」を想像するかもしれません。
しかし安全対策の目的は、単純にAIの発展を止めることではありません。
自動車にはアクセルだけでなく、ブレーキ、シートベルト、信号、道路交通法があります。
飛行機にはエンジンだけでなく、複数の安全装置、管制、整備基準、事故調査制度があります。
これらがあるからこそ、高性能な技術を社会で利用できます。
AIでも同じです。
能力向上と安全性向上を競争させるのではなく、同時に発展させること
が重要です。
AIがより多くの仕事を行えるようになるなら、より高度な監査技術も必要になります。
AIが高速に研究できるなら、安全性研究も高速化する必要があります。
AIが複数で協力するなら、監視する仕組みも組織レベルへ進化させる必要があります。
まとめ|AIの進化より先に安全対策を準備する
AIの安全問題は、未来のASIだけの問題ではありません。
生成AIには生成AIのリスクがあります。
AIエージェントにはAIエージェントのリスクがあります。
マルチAIエージェントには、AI組織としての新しいリスクがあります。
そしてAI科学者、AIによるAI研究、RSI、AGI、ASIへ進むほど、問題は「間違った回答を出す」ことから、「間違った行動をする」「大量のAIが協力して行動する」「AI自身が能力を高める」ことへ変化していく可能性があります。
そのため、
従来型コンピューター
↓
機械学習
↓
LLM・生成AI
↓
推論AI
↓
AIエージェント
↓
マルチAIエージェント
↓
AI科学者
↓
AIによるAI研究
↓
RSI
↓
AGI
↓
ASI
↓
知能爆発・シンギュラリティ
という進化を考えるとき、安全対策も同じように段階的に高度化させる必要があります。
そして、最も重要な原則は、
「次の段階へ進んでから安全対策を考える」のではなく、「次の段階へ進む前に必要な安全対策を準備する」
ことです。
AIの未来が、人類と対立する暗い未来になると決まっているわけではありません。
AIによって科学研究が加速し、新薬、エネルギー、教育、医療、環境問題などの解決が進む可能性もあります。
一方で、高度な能力には、それに見合った安全設計が必要です。
目指すべきなのは「AIを進化させるか、安全にするか」という二者択一ではなく、
AIの能力と安全性を同時に進化させ、人間が重要な意思決定と統治を維持しながらAIの恩恵を利用できる社会
でしょう。
AIがAIを研究する時代になってから安全性を考え始めるのでは、遅い可能性があります。
だからこそ、現在の生成AIやAIエージェントの段階から、権限管理、評価、監査、停止手段、アラインメント、国際協力を積み重ねていくことが重要です。
AIの進化で本当に問われているのは、どこまで賢いAIを作れるかだけではありません。
その知能を、人類がどこまで安全に利用できる仕組みを作れるのか。
それが、AIの進化と同時に解決しなければならないもう一つの大きな課題です。